Leçon 14 · Avancé · 15 min
Modèles de raisonnement o1 et o3-mini : pensée complexe
Comprendre les modèles o1 et o3-mini : chaîne de pensée masquée, raisonnement logique profond, calculs complexes et arbitrage vitesse et coût.
- Objectif
- Vous saurez identifier les cas d'usage justifiant l'utilisation des modèles o1 et o3-mini et structurer vos requêtes pour exploiter leur réflexion interne.
- Compétences
- Cadrer

Les modèles de raisonnement OpenAI o1 et o3-mini introduisent une rupture fondamentale en consacrant du temps de calcul à l'inférence pour réfléchir avant de répondre. Contrairement aux modèles traditionnels qui écrivent sans temps mort, la série o1 génère une chaîne de pensée interne masquée où elle teste des hypothèses, détecte ses propres erreurs et ajuste sa stratégie. Cette puissance est réservée aux problèmes complexes de logique, de droit et de modélisation.
1La chaîne de pensée interne et le temps de calcul à l'inférence
La chaîne de pensée interne et le temps de calcul à l'inférence représentent le nouveau paradigme de performance de l'intelligence artificielle. Traditionnellement, l'amélioration des modèles reposait sur l'augmentation du volume de données d'entraînement. Avec o1, la puissance s'accroît également pendant le temps où le modèle réfléchit à votre question.
Le modèle apprend par renforcement à corriger ses propres erreurs au cours de son monologue interne. Il décompose le problème, explore des chemins alternatifs et écarte les impasses avant de formuler la première phrase publique. Ce processus élimine une vaste proportion d'erreurs logiques et d'hallucinations de raisonnement.
Modèle Caractéristique majeure Temps de réponse Usage recommandé GPT-4o Multimodal direct, écriture fluide, recherche web 1 à 3 secondes Rédaction, synthèses, brainstorming courant OpenAI o1 Raisonnement lourd, logique formelle, arbitrages 10 à 45 secondes Droit complexe, modélisation financière, R&D OpenAI o3-mini Raisonnement optimisé pour le code et les maths 3 à 12 secondes Revue de code, scripts d'analyse, logique pure 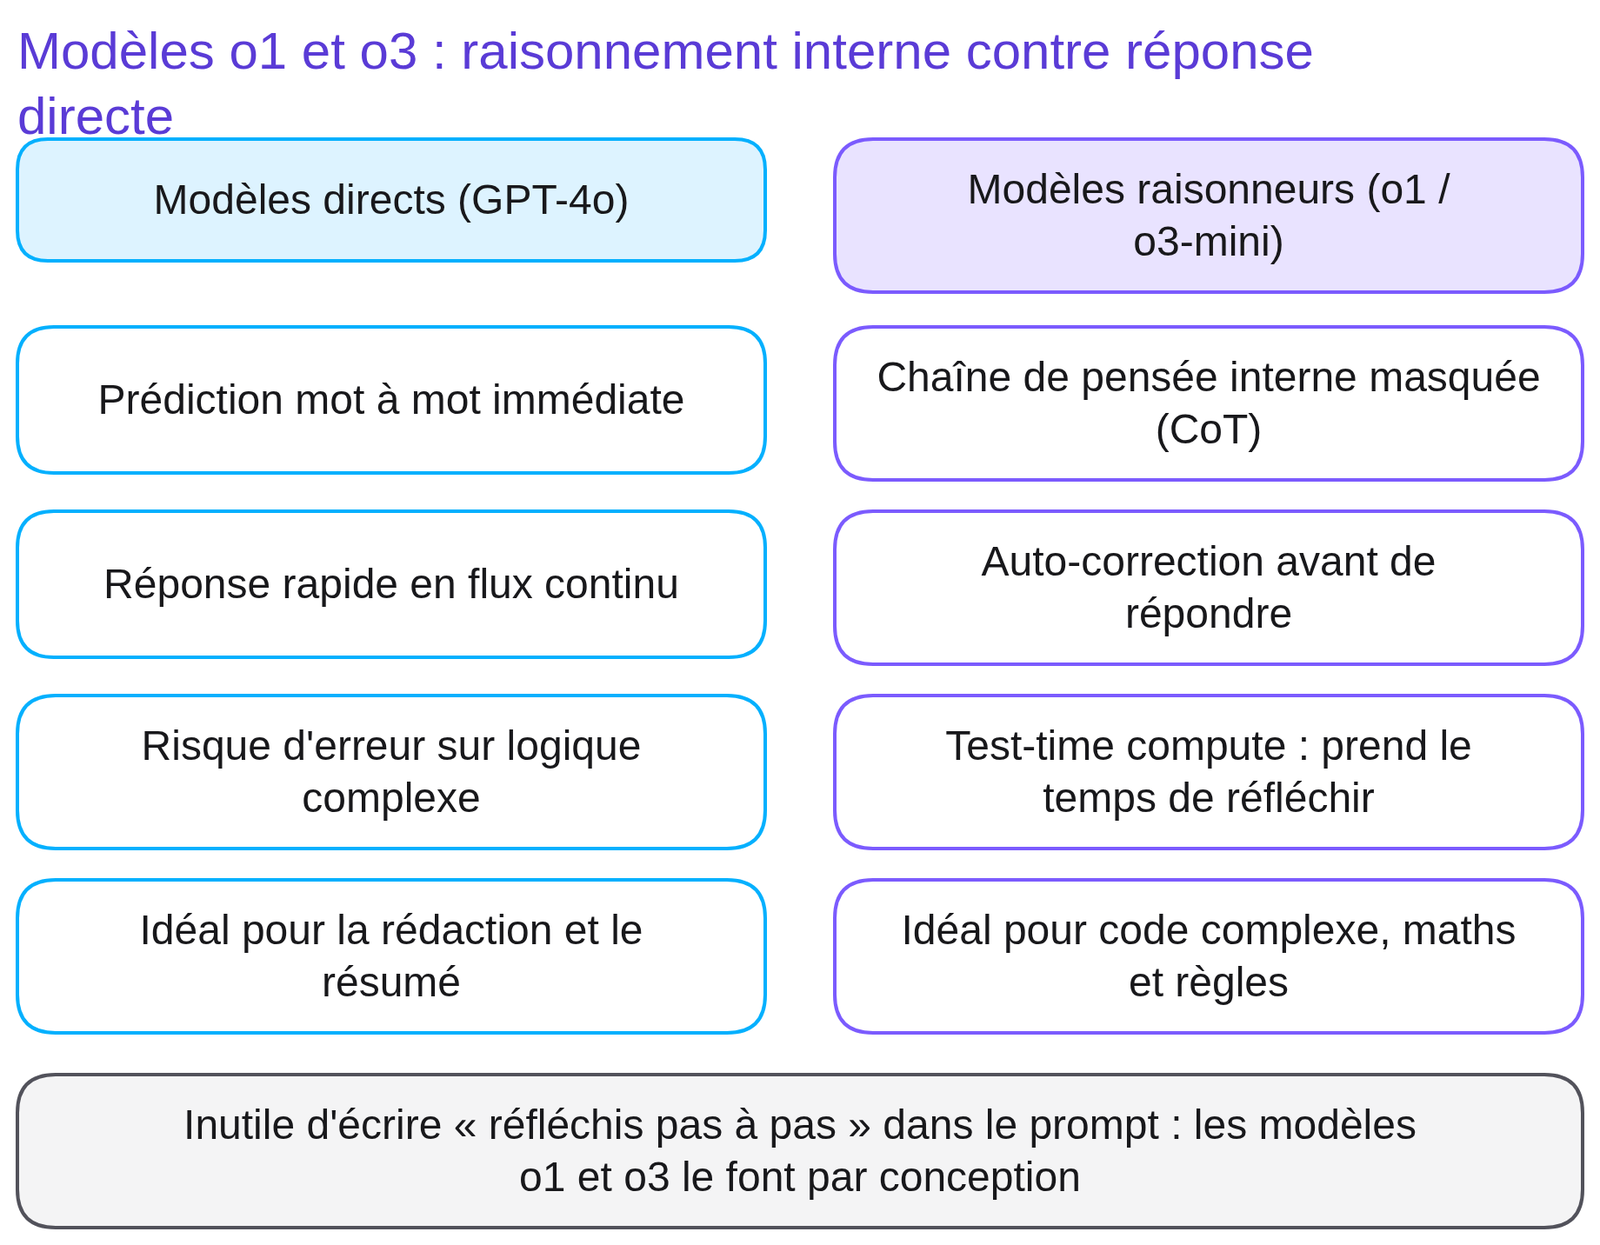
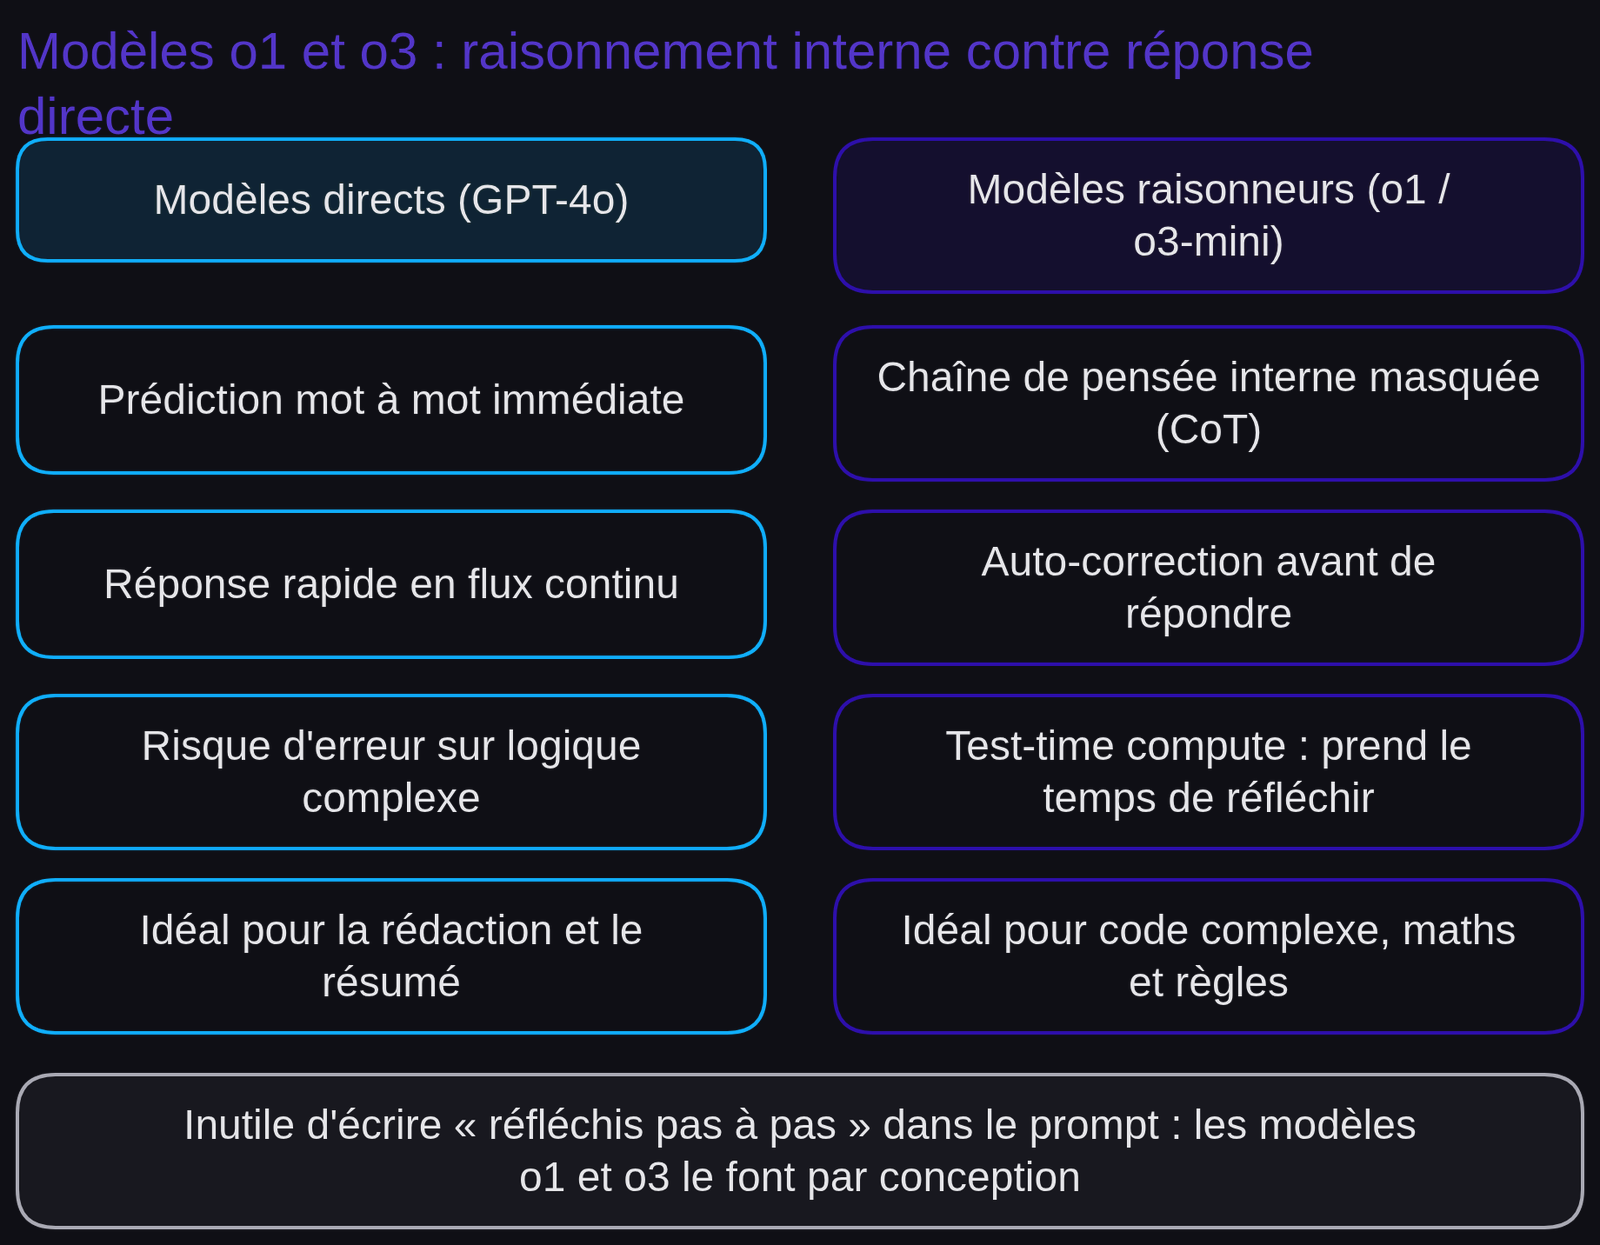
Schéma des modèles de raisonnementSchéma généré par IA et relu 2Résoudre un arbitrage budgétaire sous contraintes réglementaires
Résoudre un arbitrage budgétaire sous contraintes réglementaires montre la supériorité des modèles de raisonnement sur les problèmes combinatoires où les modèles classiques se contredisent.
Une directrice des opérations doit allouer une enveloppe d'investissement entre trois usines avec des contraintes de subventions publiques et de seuils d'effectifs.
Prompt faible.
Répartis 2 millions d'euros entre nos trois usines A, B et C en respectant nos contraintes habituelles.Un modèle standard propose une ventilation équilibrée au hasard sans vérifier le respect mathématique des seuils.
Prompt fort (Tour 1 - o1).
Rôle : Directeur financier et modélisateur quantitatif.
Problème : Répartis un budget total de 2 000 000 € entre trois sites (A, B, C).
Contraintes impératives :
1. Le site A doit recevoir au minimum 40 % du budget total pour débloquer une subvention régionale.
2. Le site B ne peut pas recevoir plus de 500 000 € en raison d'un plafond de trésorerie local.
3. Le ratio d'investissement par salarié doit être équilibré : A compte 100 salariés, B compte 50 salariés, C compte 150 salariés.
4. Aucun budget ne peut être inférieur à 200 000 €.
Livrable : Tableau de répartition exact, justification mathématique de l'optimisation et vérification ligne par ligne du respect des 4 contraintes.
Le modèle o1 prend 15 secondes pour tester les combinaisons possibles et produit une solution mathématiquement irréprochable qui valide chaque contrainte.
Tour 2 : Relance d'arbitrage sous nouvelle contrainte.
Pendant le comité de direction, une contrainte environnementale imprévue s'ajoute :
Garde exactement les mêmes données, mais ajoute cette 5e contrainte : le site C doit recevoir au moins 25 % du budget total pour son raccordement au réseau de chaleur. Réajuste la répartition optimale en démontrant la faisabilité.Le modèle o1 alloue 10 secondes de réflexion interne supplémentaires et rééquilibre la matrice sans violer les quatre premières bornes.
Ce qui change. Le temps de réflexion permet au modèle d'explorer l'espace combinatoire et de vérifier les équations avant de répondre, même sous contraintes croisées.
3Formuler un problème logique pour le modèle de raisonnement
Formuler un problème logique pour le modèle de raisonnement vous apprend à solliciter l'IA sur des défis combinatoires à forte valeur ajoutée sans la brider par des consignes de calcul artificielles.
Pour vous exercer sans manipuler de plannings réels, voici la matrice opérationnelle d'un centre logistique (société fictive NovaTech SAS) :
[Centre logistique NovaTech SAS - Tournées de distribution]
Dépôts régionaux :
- Nantes : demande 6 tonnes (livraison : Jour 1 matin ou Jour 2 matin)
- Rennes : demande 8 tonnes (livraison : Jour 1 après-midi uniquement)
- Bordeaux : demande 11 tonnes (livraison : Jour 2 journée entière)
- Toulouse : demande 9 tonnes (livraison : Jour 2 avant midi impérativement)

Flotte disponible (au départ de la plateforme centrale) :
- Véhicule V1 : capacité 10 tonnes (rayon d'action : 450 km max/jour)
- Véhicule V2 : capacité 15 tonnes (rayon d'action : 500 km max/jour)
- Véhicule V3 : capacité 12 tonnes (rayon d'action : 400 km max/jour)

Réglementation transport : temps de conduite maximal de 7 heures par chauffeur et par jour.
Le bouton « Charger l'exercice » du composeur préremplit l'objectif avec le prompt de départ faible :
« Planifie la rotation de 3 véhicules pour livrer 4 dépôts régionaux en 2 jours. »
À partir de ce point de départ, complétez le prompt dans le composeur. Définissez le rôle d'ingénieur logistique, insérez la matrice ci-dessus et formulez les quatre contraintes impératives (capacités de charge, créneaux horaires stricts, temps de conduite plafonné).
Imposez une restitution sous forme de tableau jour par jour avec démonstration du respect de chaque contrainte. Constatez l'allocation de temps de calcul à l'inférence (Inference-Time Compute, arXiv:2408.03314) qui explore les combinaisons avant de vous fournir un planning vérifié.
4Utiliser o1 pour des tâches simples de rédaction courante ou de traduction
Utiliser o1 pour des tâches simples de rédaction courante ou de traduction fait perdre un temps précieux et consomme inutilement vos quotas de raisonnement.
Demander à o1 de corriger les fautes d'un e-mail d'invitation à un déjeuner d'équipe prendra 20 secondes de réflexion interne pour un résultat textuel identique à celui que GPT-4o produit en 800 millisecondes.
Correction : réservez la série o1 aux problèmes qui exigeraient plus de 30 minutes de réflexion humaine concentrée (mathématiques, algorithmique, droit fiscal, stratégie).
Règle à retenir : si un stagiaire peut répondre à votre consigne en 10 secondes, utilisez GPT-4o, pas o1.
5Quiz
Trois questions, correction immédiate. Le retour explique chaque option.
6Preuve de maîtrise
Rédigez une invite décrivant un cas d'optimisation sous contraintes multiples, soumettez-la à o1 ou o3-mini et vérifiez la cohérence mathématique de la solution.
Critères


Pour aller plus loin
Consultez le glossaire aux entrées modele-de-raisonnement et chaine-de-pensee. Poursuivez vers la leçon 15 : Créer un Custom GPT sans code. Pour approfondir le paramétrage avancé, découvrez OpenAI Playground et paramétrage fin.
Questions fréquentes
Qu'est-ce qui différencie la série o1 de GPT-4o ?
GPT-4o répond quasi instantanément en prédisant le texte en flux direct, alors que o1 passe plusieurs secondes à dérouler une chaîne de pensée interne pour explorer et corriger ses hypothèses avant d'émettre sa réponse finale.
Peut-on voir la chaîne de pensée complète d'un modèle o1 ?
Non, OpenAI affiche un résumé succinct de la réflexion pour des raisons de sécurité et de propriété intellectuelle, tandis que les tokens de pensée bruts restent masqués.
Quand faut-il choisir o3-mini plutôt que o1 ?
o3-mini est idéal pour les problèmes d'analyse de code, de mathématiques et de logique pure nécessitant une grande rapidité et des quotas d'usage plus élevés que le grand modèle o1.